- Astro
- TypeScript
- JSON Schema
- pdfmake
RadiografIA
- Fecha
- Octubre de 2026
- Estado
- En producción
Pon tu texto a contraluz: señala los rasgos de estilo que los asistentes de IA dejan más que las personas. 50 reglas con sus fuentes, 6 géneros calibrados; nada sale del navegador.
Por qué existe
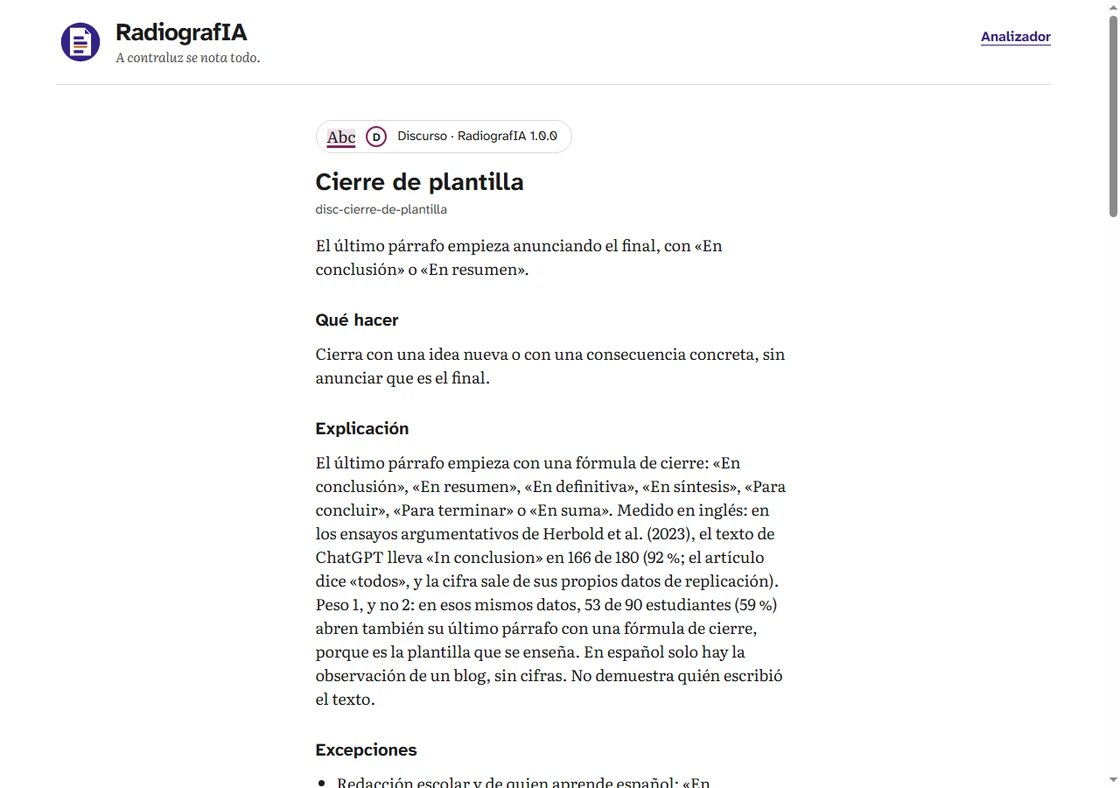
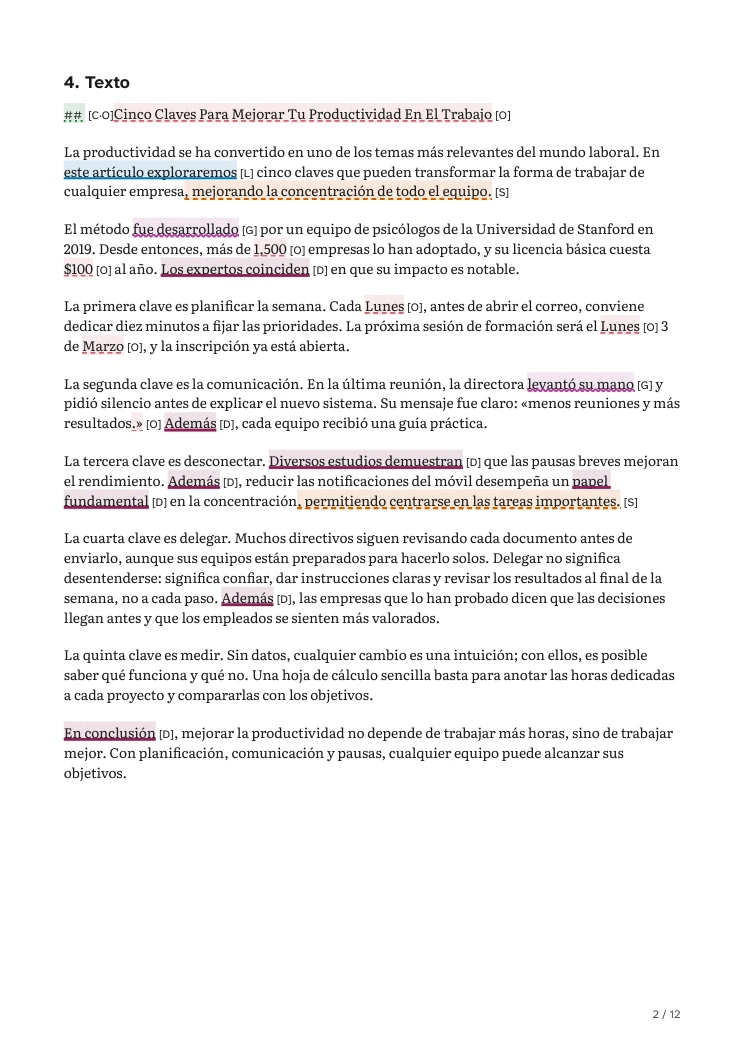
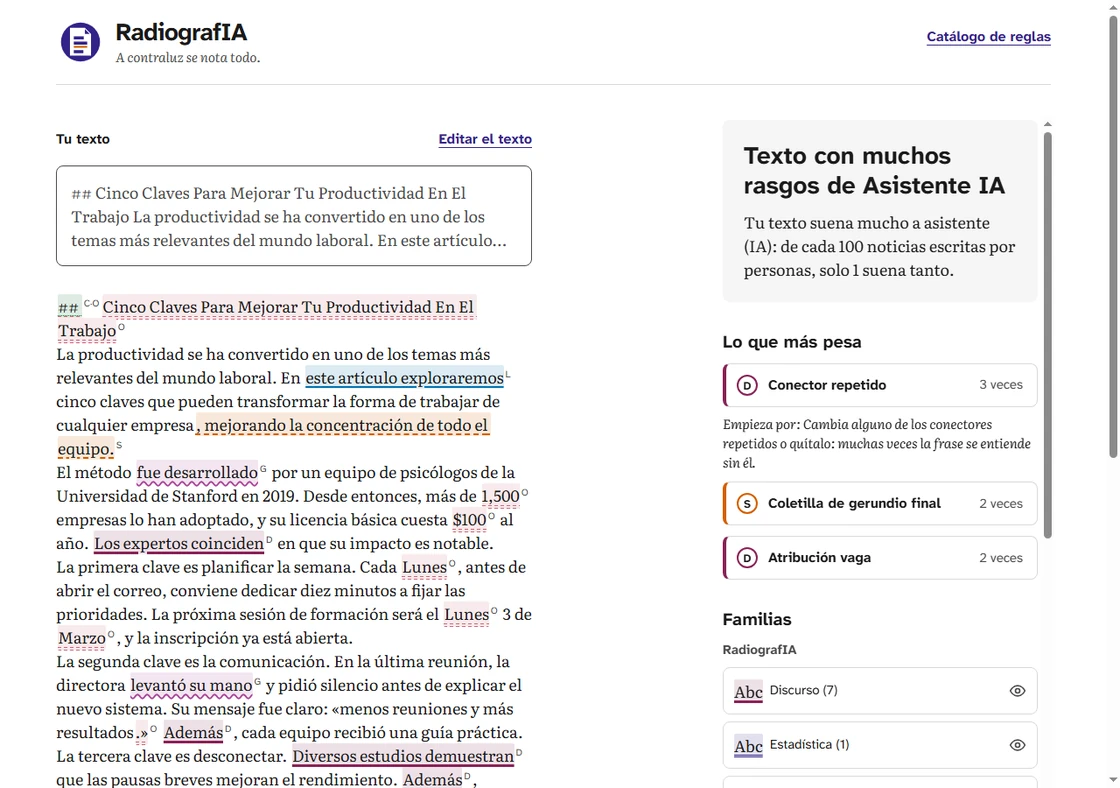
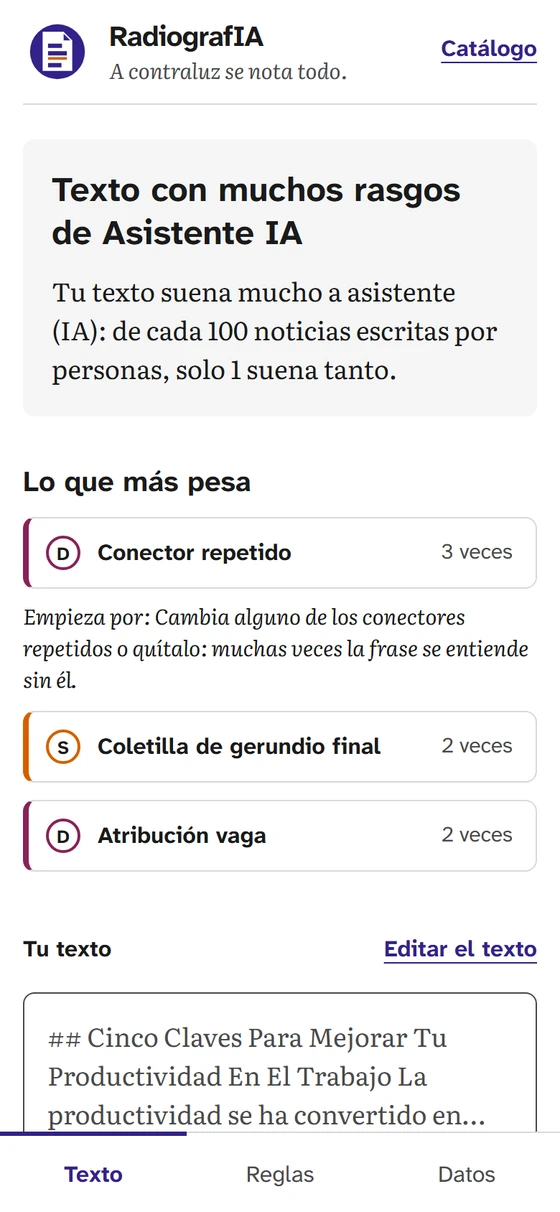
RadiografIA analiza un texto en español y marca los rasgos de estilo que, según sus fuentes, los asistentes de chat dejan más que las personas. Lo compara con textos escritos por personas, del mismo género y la misma longitud, y dice a qué suena. Nunca quién lo escribió.
Nació de mi propio trabajo con IA. Tengo un sistema de reglas para que los textos que escribo con ella suenen a persona, y con el tiempo me sirvió también para notar cuándo alguien me contesta con un texto que ha dejado entero en manos de la IA. RadiografIA convierte esa experiencia en una herramienta.
Por dentro, el motor no sabe nada de IA: aplica paquetes de reglas en JSON. RadiografIA es uno de ellos, y cualquiera puede cargar el suyo, por ejemplo con la guía de estilo de su empresa, sin que el fichero salga del navegador.
Decisiones
Todo corre en el navegador. No hay backend ni cuentas ni cookies, y el texto no sale del ordenador de quien lo pega. El informe en PDF también se genera allí, en un trozo de código que solo se descarga al pulsar «Descargar informe».
Cada regla cita sus fuentes y lleva su nivel de evidencia, y ese nivel limita lo que pesa: lo medido en textos en español pesa hasta 3; lo que solo cuentan guías y observaciones, hasta 1. Las reglas estadísticas no usan umbrales fijos. Comparan el texto con los percentiles de textos de personas de su género y su longitud.
El único etiquetador gramatical para español escrito en JavaScript se midió contra un corpus anotado y se quedó por debajo del 85 % que se le pedía. Las reglas que dependían de él se quedaron fuera.
Cómo lo comprobé
- 1.217tests en la suite
- 1.703textos de personas apartados para validar
- 97,9 %de textos de personas sin falsa alarma
- 308tests de la web, todos pasados en producción
La suite tiene 1.217 tests: 909 del motor y 308 de la web. Los de la web abren la página en Chrome y miden lo que se ve: el contraste, el orden del foco, el tamaño de lo que se pulsa y los 320 px sin scroll horizontal.
Para validar la calibración se apartó el 20 % de cada corpus antes de medir nada. En esos textos de personas, dos o más reglas estadísticas saltan en el 2,1 % (35 de 1.703). Ya publicada, la parte de la web volvió a pasar contra producción: 308 de 308.
Lo que no hace
No dice quién escribió un texto. Una persona puede tener esos rasgos y un asistente puede no tenerlos, y por eso la frase dice «suena a». El texto de ejemplo que generó Claude Opus 5.5 sin instrucciones de estilo sale con muy pocos rasgos de asistente.
Tampoco da cifras de acierto: haría falta un corpus de textos de asistente medido con el mismo cuidado. Con menos de 100 palabras no analiza, y las columnas y los blogs de hoy, la narrativa contemporánea, el lenguaje corporativo y el español de América no están calibrados, porque no tienen corpus abierto con licencia.
Resultado
En producción desde el 6 de octubre de 2026: 50 reglas en dos paquetes, 6 géneros calibrados y 54 páginas, con un catálogo donde cada regla tiene su ficha con sus fuentes.
Lo que me llevo y lo que viene
El siguiente paso es hacerla más modular. Hoy se puede cargar un paquete de reglas propio, pero entero y solo mientras dura la visita: al recargar la página, desaparece. La idea es una intranet donde activar o desactivar cada regla con un clic y que la elección se quede guardada.
Así servirá para algo más que la IA: por ejemplo, para que una empresa revise sus textos con su propio lenguaje corporativo.
Más capturas